Qué ha salido.
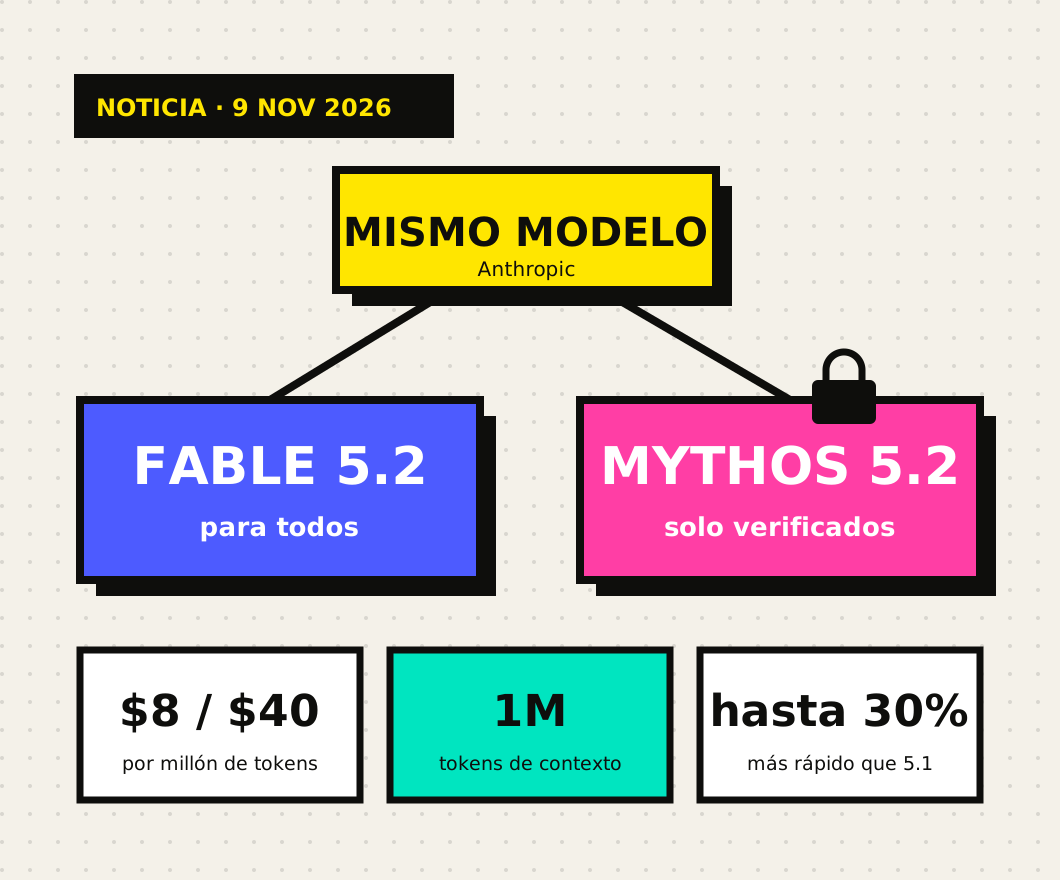
El 9 de noviembre de 2026 Anthropic anunció dos modelos a la vez: Claude Fable 5.2 y Claude Mythos 5.2. Sustituyen a Fable 5.1 y Mythos 5.1. Según Anthropic, los dos comunican con más claridad que la versión anterior, mejoran en programación, razonamiento y visión, y generan texto hasta un 30% más rápido.
Fable 5.2 ya está disponible en todas las plataformas. Mythos 5.2 solo lo pueden usar las organizaciones que entran en sus programas de verificación.
Un modelo, dos accesos.
Lo primero que hay que entender es que no son dos modelos distintos. El anuncio lo dice sin rodeos: Fable y Mythos son el mismo modelo de base. La diferencia está en quién puede usarlo y con qué límites.
| Fable 5.2 | Mythos 5.2 | |
|---|---|---|
| Quién | Cualquiera: apps de Claude, API y nubes | Organizaciones verificadas |
| Salvaguardas | Fuertes en ciberseguridad y biología | Menos restricciones en esos dos campos |
| Para qué | El trabajo técnico más difícil y largo | Ciberdefensa e investigación en ciencias de la vida |
| Cómo se accede | Directamente | Cyber Verification Program o Life Sciences Verification Program |
Si le haces a Fable 5.2 una pregunta de ciberseguridad o biología que cae en la zona bloqueada, Anthropic responde con un modelo anterior en lugar de negarse sin más. Dice también que, en sus primeras pruebas, Fable 5.2 bloquea un 55% menos de peticiones inofensivas que Fable 5.1.
Las empresas con Claude Enterprise ya usan Mythos 5.2 de forma indirecta a través de Claude Security, que ahora funciona con este modelo.
Novedades de Claude Fable 5.2.
Todas las cifras de esta sección son de Anthropic. Son pruebas internas o de terceros elegidas por la propia empresa, así que tómalas como lo que son: la versión del fabricante.
- Programación con agentes: 49,1% en FrontierCode 2.0 con esfuerzo Xhigh, frente al 45,5% de Opus 5.5 y el 32,4% de Fable 5.1. Anthropic dice que es la mejor puntuación de los modelos publicados que ha probado.
- Uso del ordenador: 89,3% en OSWorld 2.1.
- Robótica y hardware: 64,9% en RoboDojo Sim, frente al 27,6% de Fable 5.1, y 83,5 en BenchCAD 2.1 con esfuerzo Max, frente a 65,3 de Opus 5.5.
- Ciberseguridad (Mythos 5.2): en la prueba interna CVE Rediscovery encontró un 10,2% más de vulnerabilidades que Opus 5.5 y un 14,4% más que Mythos 5.1.
- Matemáticas: Anthropic cuenta que unos 1.000 agentes de Fable 5.2 formalizaron el último teorema de Fermat en Lean en 30 horas. Es la afirmación más llamativa del anuncio y no la hemos podido comprobar.
- Modo rápido: opcional, genera tokens hasta 2,5 veces más rápido y cuesta el doble.
Anthropic reconoce que en tareas de investigación de IA, como optimizar kernels o diseñar arquitecturas de modelos, los dos rinden más o menos como Opus 5.5.
Precio y disponibilidad.
| Concepto | Fable 5.2 | Mythos 5.2 |
|---|---|---|
| Entrada / salida (por millón de tokens) | $8 / $40 | $8 / $40 |
| Batch | $4 / $20 | $4 / $20 |
| Modo rápido | $16 / $80 | $16 / $80, solo verificados |
| Contexto / salida máxima | 1M / 128K tokens | No publicado |
| ID en la API | claude-fable-5-2 | No publicado |
| Dónde | Claude, API, AWS, Google Cloud, Microsoft Azure | Programas de verificación |
Para probar Fable 5.2 en Claude Code o con el SDK basta con cambiar el modelo:
{
  "model": "claude-fable-5-2"
}
En los planes de suscripción, Anthropic dice que Fable entra en Pro y en los puestos estándar de Team hasta el 50% del límite de uso semanal. Además, por defecto Anthropic guarda los datos 30 días para vigilancia de seguridad. Si eso te afecta, revisa las condiciones antes de mover trabajo sensible.
Qué recomienda la propia Anthropic.
Este es el detalle que más nos gusta del anuncio. Anthropic no dice que cambies todo a Fable. Recomienda empezar con Opus 5.5 para la mayoría del trabajo, porque cuesta la mitad ($4 / $20), y subir a Fable o Mythos solo para lo más difícil: proyectos técnicos largos y abiertos, con muchos agentes trabajando a la vez.
Si ya tienes agentes en producción con Opus 5.5, no hay prisa. Elige una tarea que hoy se le atasque, pásala a Fable 5.2 con el mismo prompt y compara el resultado y el coste. Si no mejora lo bastante para pagar el doble, quédate como estás.
En seguridad, Anthropic explica que antes del lanzamiento el modelo lo probaron evaluadores externos como el UK AI Security Institute y METR, y que considera bajo el riesgo de comportamiento desalineado en situaciones críticas. También admite que estos dos modelos sospechan que están siendo evaluados más a menudo que cualquier modelo reciente suyo. Los detalles están en la ficha del sistema.
Lo que esperamos ver en las próximas horas.
Esto ya es opinión nuestra, no un dato. Cuando sale un modelo de este nivel suele pasar lo mismo, y esperamos que esta vez también: probablemente veremos cientos de proyectos hechos con estos modelos en las redes sociales en las próximas horas. Seguramente habrá juegos, apps, demos de agentes y comparativas.
Muchos serán impresionantes y algunos estarán preparados para la foto. Antes de creerte una demo, pregunta tres cosas: con qué esfuerzo se hizo, cuánto costó y cuántos intentos hicieron falta. En SKOA vamos a probarlo con nuestros propios agentes y contaremos lo que encontremos, también lo que no funcione.
Fuentes.
Más noticias y tutoriales sobre agentes en el blog de SKOA. Si quieres ver un agente con Claude de principio a fin, empieza por cómo crear un agente de marketing con Claude.